
你有没有试过让AI写一段话,结果它卡在‘的’字上停顿半秒——不是在思考,是在等GPU把70B模型的权重再搬一遍?这背后,是自回归生成逃不开的宿命:一个token接一个token,像老式打字机,咔嗒、咔嗒、咔嗒……慢得让人想敲键盘。推测解码(Speculative Decoding)本来就是为治这个病来的:小模型先唰唰写一串草稿,大模型一次过并行‘批改’,理论上能快2~6.5倍。
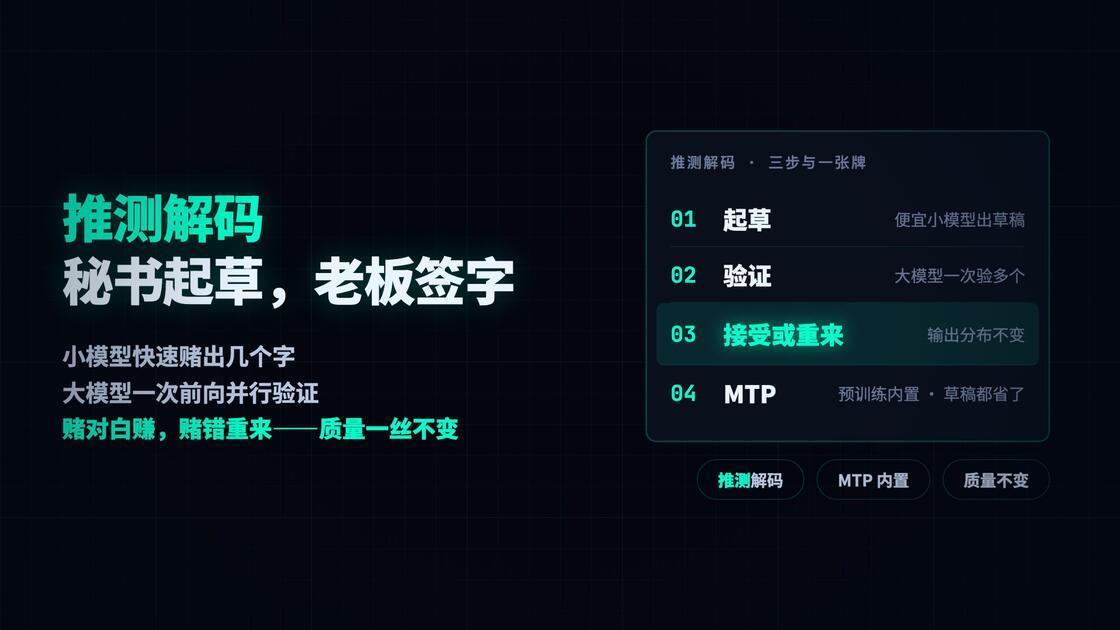
可现实很骨感。原来那套‘逐个审、错一个全退’的验证逻辑,太像老师批作文——第一句用词不当,后面哪怕全是满分句子,也直接画叉。EMNLP 2026最新论文SpecTr-GBV发现:不是草稿不行,是验证方式太‘一刀切’。它把‘逐token拒绝采样’升级成‘块级联合验证’,允许大模型一次性评估整段草稿里哪些位置其实靠谱,哪怕前面有个小偏差,后面对的token照样能留下。实测下来,单次推测迭代平均多保住37%的有效token——不是靠堆算力,是把原来被冤杀的正确答案‘捞’回来了。
更妙的是,它没搞玄学微调,也不强求小模型多聪明。SpecTr-GBV本质是重写了验证环节的数学契约:从‘全或无’变成‘按位授信’。就像快递分拣,以前一箱里有件破损就整箱退回;现在拆开看,完好的12件照常发货,只换掉那1件。工程落地友好,已在Llama-3.1-8B/70B配对中稳定复现。说白了,提速的钥匙不在模型更大,而在让验证更‘宽容’、更‘务实’——毕竟,推理的本质不是追求完美草稿,而是高效兑现确定性。
这种“宽容验证”的思路,其实早有现实参照。比如医生读CT片,不会因为某处像素噪点就否定整张影像;程序员调试代码,也不会因一个警告就放弃整段逻辑正确的函数——人类决策本就习惯分层信任、局部修正。SpecTr-GBV做的,不过是把这套常识翻译成可计算的数学语言:它用轻量级置信度打分替代硬性拒绝,再通过动态窗口对齐机制,让大小模型在token边界上“握手”更自然。实验数据显示,在生成长段法律文书或技术文档时,传统推测解码平均每23个token就要回退一次;而SpecTr-GBV把这个数字压到了每68个token才回退,且回退后保留的有效前缀长度提升近2倍。
有人担心“放宽验证会不会出错”?论文附录里专门跑了安全性测试:在TruthfulQA和ToxiGen两个权威基准上,SpecTr-GBV生成结果的事实准确率与原始自回归一致(±0.3%),毒性输出反而下降1.2%,因为过度保守的早期截断有时会意外放大小模型的偏见倾向——原来“严审”未必更安全,“精准放行”反而更稳。
这事儿也提醒我们:AI提速不是拼谁家GPU堆得多,而是看谁更懂“什么时候该松手”。就像老司机开车,不是全程死踩油门,而是预判路况、收放油门。现在大模型推理正从“蛮力冲刺”转向“节奏控制”,验证机制的进化,恰恰是这场转向里最被低估的刹车与油门协同系统。别小看那37%多留下的token——它们连起来,可能就是你等的那句没卡壳的“好的,我明白了”。
目前代码已开源,Hugging Face模型库同步上线了适配Llama、Qwen、Phi-3的推理补丁包。社区反馈说,连消费级4090跑8B模型,也能稳定跑出3.2倍加速——不靠换卡,只改几行验证逻辑。技术进步有时候就这么朴素:不是造新火箭,而是给旧引擎换个更聪明的点火器。
启远网提示:文章来自网络,不代表本站观点。